


 Khóa học CompTIA Security+ OnlineBài 79. AI trong vận hành bảo mật: agentic AI, chatbot, predictive analysis, AI-augmented baseline
Bài 79. AI trong vận hành bảo mật: agentic AI, chatbot, predictive analysis, AI-augmented baseline
Khóa học CompTIA Security+ SY0-801 · Phần 4: Vận hành bảo mật · Bài 79 · 🎯 Objective 4.6 (mới trong V8) · ⏱️ Đọc khoảng 16 phút · 🧪 Không cần lab · 📝 5 câu bài tập cuối bài
🎯 Mục tiêu bài học
- Hiểu các cách AI hỗ trợ vận hành bảo mật: chatbot, phân tích dự đoán, đường cơ sở tăng cường bằng AI, agentic AI.
- Biết lợi ích và đặc biệt các rủi ro riêng của AI: kết quả sai thuyết phục, rò rỉ dữ liệu, prompt injection, thiên lệch, phụ thuộc quá mức.
- Nắm nguyên tắc dùng AI an toàn: giữ con người trong vòng lặp, quyền tối thiểu, bảo vệ dữ liệu, giám sát và kiểm chứng.
- Liên hệ với tự động hóa ở bài trước.
📎 Vị trí trong đề thi: đây là nội dung mới trong phiên bản V8 của Objective 4.6, nên cách hỏi trong đề còn ít tiền lệ. Bài này viết theo hướng khái niệm và nguyên tắc chung; hãy đối chiếu với tài liệu objectives chính thức của CompTIA khi họ cập nhật. Nó nối tiếp Bài 78 (tự động hóa), dùng lại SIEM và baseline (Bài 71, Bài 72), đặc quyền tối thiểu (Bài 76) và bảo vệ dữ liệu (Bài 52).
💡 Liên hệ thực tế: trợ lý AI và dữ liệu khách hàng
Nam bắt đầu dùng một trợ lý AI để tóm tắt cảnh báo và gợi ý bước xử lý. Hiệu quả thấy ngay: một cảnh báo dài 3 trang được tóm gọn trong 5 dòng. Nhưng một lần, trợ lý tự tin khẳng định một địa chỉ IP thuộc "nhà cung cấp tin cậy" trong khi thực tế không phải, và đề xuất bỏ qua cảnh báo. Nếu Nam tin ngay thì đã bỏ sót một cuộc tấn công. Một nhân viên khác thì dán nguyên bảng khách hàng vào một dịch vụ AI công cộng để nhờ phân tích. Đây là tình huống minh họa, không phải vụ việc có thật.
Nam chốt lại: AI là công cụ hỗ trợ, không phải người quyết định; kiểm chứng đầu ra, không đưa dữ liệu nhạy cảm vào dịch vụ không kiểm soát, và giới hạn quyền của bất kỳ AI nào được phép hành động.
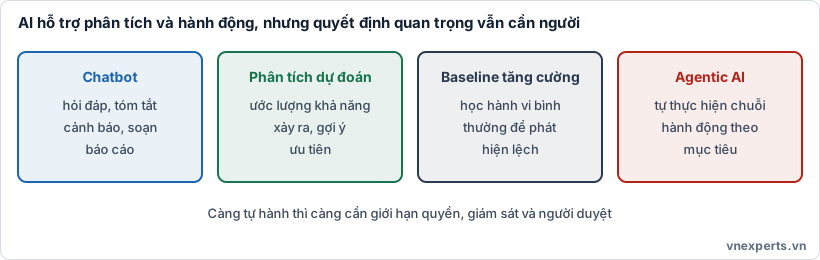
🧠 Hình 79a. AI hỗ trợ phân tích và hành động, nhưng quyết định quan trọng vẫn cần người.
📘 Kiến thức cốt lõi
🧰 Các cách AI hỗ trợ vận hành bảo mật
| Ứng dụng | Mô tả | Ví dụ |
|---|---|---|
| Chatbot / trợ lý AI | Người trực hỏi bằng ngôn ngữ tự nhiên và nhận câu trả lời | Tóm tắt cảnh báo, giải thích một lệnh lạ, soạn báo cáo sự cố, tra cứu quy trình nội bộ |
| Phân tích dự đoán (predictive analysis) | Dùng dữ liệu quá khứ để ước lượng điều có khả năng xảy ra | Ước lượng lỗ hổng nào dễ bị khai thác, máy nào có nguy cơ cao, xu hướng tăng cảnh báo |
| Đường cơ sở tăng cường bằng AI (AI-augmented baseline) | Học hành vi bình thường của người dùng, thiết bị, mạng, rồi phát hiện sai lệch | Cảnh báo khi một tài khoản đột ngột tải lượng dữ liệu lớn, hoặc một máy chủ kết nối tới nơi chưa từng liên hệ |
| Agentic AI (AI tự hành) | AI tự lập kế hoạch và thực hiện chuỗi hành động để đạt một mục tiêu, thường bằng cách gọi công cụ và API | Nhận cảnh báo, tự tra cứu, tự cách ly máy, tự tạo phiếu rồi báo kết quả |
Agentic AI khác chatbot ở chỗ nào: chatbot trả lời; agentic AI hành động. Vì hành động trong hệ thống thật có hệ quả, nó cần các giới hạn chặt (quyền, phạm vi, phê duyệt) hơn nhiều so với chatbot thuần hỏi đáp. Nó có thể xem như bước tiến của SOAR (Bài 78): thay vì chạy kịch bản cố định, AI tự chọn bước cho từng tình huống.
✅ Lợi ích
- Giảm tải cho người trực: tóm tắt, phân loại, lọc nhiễu hàng nghìn cảnh báo (giảm alert fatigue, Bài 72).
- Tăng tốc phân tích: đọc log và tài liệu rất nhanh, đưa ra giả thuyết ban đầu.
- Phát hiện bất thường mà quy tắc cố định bỏ sót, nhờ baseline học từ dữ liệu thật.
- Hỗ trợ người mới: giải thích khái niệm, lệnh, quy trình; chuẩn hóa cách viết báo cáo.
- Ưu tiên tốt hơn: kết hợp nhiều tín hiệu để xếp hạng lỗ hổng và cảnh báo (Bài 69).
- Hoạt động liên tục và có khả năng mở rộng.
⚠️ Rủi ro riêng của AI
| Rủi ro | Giải thích | Cách giảm |
|---|---|---|
| Kết quả sai nhưng thuyết phục (hallucination, ảo giác) | AI có thể bịa chi tiết, trích dẫn sai, hoặc khẳng định chắc chắn điều không đúng | Kiểm chứng bằng nguồn tin cậy; không dùng đầu ra làm bằng chứng duy nhất |
| Dương tính giả và âm tính giả | Mô hình báo nhầm hoặc bỏ sót (Bài 69) | Tinh chỉnh, đo độ chính xác, giữ biện pháp phát hiện khác song song |
| Rò rỉ dữ liệu | Đưa dữ liệu nhạy cảm vào dịch vụ AI bên ngoài có thể làm lộ hoặc dùng cho huấn luyện | Chính sách sử dụng AI, DLP (Bài 73), dùng bản dành cho doanh nghiệp hoặc chạy nội bộ, che dữ liệu nhạy cảm (Bài 52) |
| Prompt injection | Văn bản độc hại nằm trong dữ liệu AI đọc (email, trang web, log) ra lệnh cho AI làm điều ngoài ý muốn | Tách chỉ thị với dữ liệu, hạn chế quyền của AI, xác nhận hành động nhạy cảm, lọc đầu vào và đầu ra |
| Đầu độc dữ liệu huấn luyện (data poisoning) | Kẻ tấn công làm bẩn dữ liệu học để mô hình học sai | Kiểm soát nguồn dữ liệu, kiểm thử mô hình, theo dõi sai lệch |
| Thiên lệch (bias) | Mô hình học từ dữ liệu có thiên lệch nên kết quả không công bằng hoặc bỏ sót nhóm nào đó | Đánh giá trên nhiều nhóm dữ liệu, rà soát định kỳ |
| Khó giải thích (explainability) | Không rõ vì sao AI đưa ra kết luận, khó kiểm toán và chứng minh | Yêu cầu giải thích, ghi log đầu vào và đầu ra, giữ người duyệt |
| Phụ thuộc quá mức | Người trực tin mù quáng, kỹ năng mai một | Đào tạo, cho người thực hành việc cốt lõi, kiểm tra ngẫu nhiên |
| Quyền quá rộng của agent | Agentic AI có thể hành động ngoài ý muốn hoặc bị lợi dụng | Đặc quyền tối thiểu, phạm vi hẹp, phê duyệt cho hành động nhạy cảm, khả năng dừng khẩn cấp |
| Pháp lý, quyền riêng tư, tuân thủ | Xử lý dữ liệu cá nhân, yêu cầu minh bạch | Tham vấn pháp chế, ghi nhận nơi dữ liệu đi qua |
🛡️ Dùng AI an toàn: giữ con người trong vòng lặp
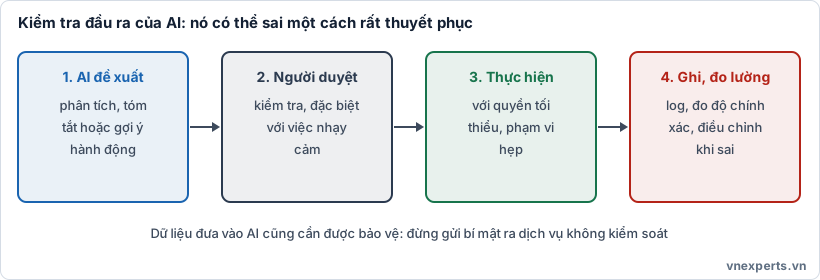
🧑💻 Hình 79b. Kiểm tra đầu ra của AI: nó có thể sai một cách rất thuyết phục.
Các nguyên tắc cốt lõi:
- Con người trong vòng lặp (human-in-the-loop): AI đề xuất, người quyết định với việc nhạy cảm hoặc không thể hoàn tác.
- Đặc quyền tối thiểu: tài khoản và khóa API của AI chỉ có đúng quyền cần, phạm vi hẹp (Bài 76, Bài 77).
- Bảo vệ dữ liệu: quy định loại dữ liệu nào được đưa vào AI; che hoặc ẩn danh dữ liệu nhạy cảm; ưu tiên giải pháp doanh nghiệp có cam kết về dữ liệu.
- Kiểm chứng và đo lường: so với kết quả đúng, theo dõi tỷ lệ sai, ghi log đầu vào và đầu ra để kiểm toán.
- Giám sát chính AI: coi AI là một thành phần hệ thống có thể bị tấn công (prompt injection, đầu độc), nên cần quản lý lỗ hổng và cấu hình như hệ thống khác.
- Có phương án dự phòng thủ công khi AI sai hoặc không khả dụng.
- Chính sách và đào tạo: nhân viên hiểu được và không được dùng AI vào việc gì.
🎯 Mẹo làm bài: "Hỏi đáp, tóm tắt, soạn báo cáo bằng ngôn ngữ tự nhiên" → chatbot / trợ lý AI. "Dùng dữ liệu quá khứ để ước lượng điều sẽ xảy ra" → phân tích dự đoán. "Học hành vi bình thường để phát hiện lệch" → AI-augmented baseline. "AI tự lập kế hoạch và thực hiện chuỗi hành động qua công cụ" → agentic AI. "AI bịa thông tin nhưng nói rất chắc chắn" → hallucination. "Văn bản độc hại trong dữ liệu ra lệnh cho AI" → prompt injection. "Làm bẩn dữ liệu huấn luyện" → data poisoning. "Dán dữ liệu nhạy cảm vào dịch vụ AI công cộng" → rủi ro rò rỉ dữ liệu. "AI đề xuất, người quyết định" → human-in-the-loop. "AI chỉ có quyền vừa đủ" → đặc quyền tối thiểu cho AI.
🧠 Áp vào câu chuyện của Nam
| Vấn đề | Biện pháp |
|---|---|
| AI khẳng định sai về một địa chỉ IP | Kiểm chứng với nguồn tin cậy (threat feed, WHOIS), không dùng AI làm bằng chứng duy nhất |
| Nhân viên dán dữ liệu khách hàng vào AI công cộng | Chính sách sử dụng AI, DLP, cung cấp công cụ AI nội bộ hoặc doanh nghiệp |
| Muốn AI tự cách ly máy nghi nhiễm | Chỉ cho phép với phạm vi hẹp, có người duyệt hoặc dừng khẩn cấp, quyền tối thiểu |
| Lo AI bị lừa bởi nội dung email độc hại | Tách chỉ thị với dữ liệu, giới hạn quyền, xác nhận hành động nhạy cảm |
| Người trực phụ thuộc quá nhiều vào AI | Đào tạo, kiểm tra ngẫu nhiên kết quả, giữ kỹ năng phân tích cốt lõi |
📖 Thuật ngữ cần nhớ
| Thuật ngữ | Nghĩa |
|---|---|
| Chatbot / trợ lý AI | Giao diện hỏi đáp bằng ngôn ngữ tự nhiên. |
| Predictive analysis | Phân tích dự đoán dựa trên dữ liệu quá khứ. |
| AI-augmented baseline | Đường cơ sở hành vi học bằng AI để phát hiện bất thường. |
| Agentic AI | AI tự lập kế hoạch và thực hiện chuỗi hành động. |
| Hallucination | AI tạo thông tin sai nhưng nghe rất chắc chắn. |
| Prompt injection | Chèn chỉ thị độc hại vào dữ liệu để điều khiển AI. |
| Data poisoning | Làm bẩn dữ liệu huấn luyện để mô hình học sai. |
| Human-in-the-loop | Con người duyệt các quyết định quan trọng của AI. |
| Explainability | Khả năng giải thích vì sao AI đưa ra kết luận. |
📌 Tóm tắt nhanh
- AI trong vận hành bảo mật gồm chatbot, phân tích dự đoán, đường cơ sở tăng cường bằng AI, agentic AI; agentic AI hành động, chatbot chỉ trả lời.
- Lợi ích: giảm tải, tăng tốc phân tích, phát hiện bất thường, hỗ trợ người mới, ưu tiên tốt hơn.
- Rủi ro riêng của AI: ảo giác, rò rỉ dữ liệu, prompt injection, đầu độc dữ liệu, thiên lệch, khó giải thích, phụ thuộc quá mức, agent có quyền rộng.
- Nguyên tắc: con người trong vòng lặp, đặc quyền tối thiểu, bảo vệ dữ liệu, kiểm chứng, giám sát chính AI, có phương án dự phòng, có chính sách.
- Đây là nội dung mới trong V8: đối chiếu thêm với tài liệu chính thức khi có.
💬 Hỏi & Đáp nhanh
❓ AI có thay thế được nhân viên SOC không? Hiện nay AI chủ yếu hỗ trợ và nâng năng suất: lọc nhiễu, tóm tắt, gợi ý. Quyết định có hệ quả lớn, phán đoán trong tình huống mơ hồ và trách nhiệm giải trình vẫn cần con người. Vai trò con người chuyển sang giám sát, kiểm chứng và xử lý ca khó.
❓ Làm sao biết AI đang "ảo giác"? Không thể tin hoàn toàn vào giọng tự tin. Hãy yêu cầu nguồn, đối chiếu với công cụ và dữ liệu gốc, kiểm tra các con số và tên cụ thể, và coi đầu ra là giả thuyết cần kiểm chứng.
❓ Dùng AI có phải là rủi ro với dữ liệu công ty không? Có thể, nếu dùng dịch vụ không kiểm soát. Rủi ro giảm khi có chính sách rõ, công cụ dành cho doanh nghiệp có cam kết bảo vệ dữ liệu, che dữ liệu nhạy cảm và DLP để phát hiện việc dán dữ liệu ra ngoài.
📝 Bài tập đánh giá
Tự chọn đáp án cho từng câu, rồi đối chiếu với phần đáp án ở cuối bài.
Câu 1. Một trợ lý AI khẳng định chắc chắn một thông tin sai nhưng nghe rất thuyết phục. Hiện tượng này gọi là gì?
- A. Prompt injection
- B. Data poisoning
- C. Credential stuffing
- D. Hallucination (ảo giác)
Câu 2. Văn bản độc hại trong một email mà AI đang đọc ra lệnh cho AI làm điều ngoài ý muốn. Đây là tấn công nào?
- A. SQL injection
- B. Brute force
- C. Prompt injection
- D. Tailgating
Câu 3. AI tự lập kế hoạch và thực hiện chuỗi hành động như tra cứu, cách ly máy, tạo phiếu thông qua công cụ và API được gọi là gì?
- A. Agentic AI
- B. Chatbot hỏi đáp
- C. Phân tích tĩnh
- D. Honeypot
Câu 4. Biện pháp nào phù hợp nhất để giảm rủi ro khi cho AI hành động trong hệ thống thật?
- A. Cấp quyền quản trị toàn hệ thống để AI không bị cản trở
- B. Đặc quyền tối thiểu, phạm vi hẹp, người duyệt hành động nhạy cảm và khả năng dừng khẩn cấp
- C. Tắt hết log để AI chạy nhanh
- D. Không cần giám sát
Câu 5. Nhân viên dán danh sách khách hàng vào một dịch vụ AI công cộng để phân tích. Rủi ro chính là gì?
- A. Hết bản quyền phần mềm
- B. Làm chậm mạng nội bộ
- C. Lỗi hiển thị
- D. Rò rỉ dữ liệu nhạy cảm ra ngoài tầm kiểm soát của tổ chức
👉 Đáp án
Câu 1: D — Hallucination là AI tạo thông tin sai nhưng nghe rất chắc chắn; cần kiểm chứng.
Câu 2: C — Prompt injection là chèn chỉ thị độc hại vào dữ liệu để điều khiển AI.
Câu 3: A — Agentic AI tự lập kế hoạch và hành động qua công cụ; chatbot chỉ trả lời.
Câu 4: B — Đặc quyền tối thiểu, phạm vi hẹp, người duyệt và dừng khẩn cấp giảm rủi ro khi AI hành động.
Câu 5: D — Dữ liệu nhạy cảm có thể lộ hoặc bị dùng ngoài kiểm soát; cần chính sách, DLP và công cụ doanh nghiệp.
📚 Bài viết thuộc khóa học CompTIA Security+ của VNExperts
🧭 Điều hướng
| ⬅️ Bài trước | 🏠 Mục lục khóa học | Bài kế tiếp ➡️ |
|---|---|---|
| Bài 78: Automation và orchestration: SOAR, scripting, API | Mục lục khóa học CompTIA Security+ | Bài 80: Quy trình ứng phó sự cố |


