


 Khóa học CompTIA Security+ OnlineBài 55. RTO, RPO, MTTR, MTBF và kế hoạch khôi phục sau thảm họa
Bài 55. RTO, RPO, MTTR, MTBF và kế hoạch khôi phục sau thảm họa
Khóa học CompTIA Security+ SY0-801 · Phần 3: Kiến trúc bảo mật · Bài 55 · 🎯 Objective 3.4 · ⏱️ Đọc khoảng 17 phút · 🧪 Không cần lab · 📝 5 câu bài tập cuối bài
🎯 Mục tiêu bài học
- Phân biệt RTO (khôi phục trong bao lâu) và RPO (chấp nhận mất bao nhiêu dữ liệu), và biết chúng quyết định thiết kế sao lưu, dự phòng như thế nào.
- Hiểu MTBF và MTTR, biết cách tính và biết chúng liên quan tới tính sẵn sàng ra sao.
- Nắm nội dung chính của kế hoạch khôi phục sau thảm họa (DR plan) và phân biệt với kế hoạch duy trì hoạt động kinh doanh (BCP).
- Phân biệt hot site, warm site, cold site và các hình thức kiểm thử kế hoạch DR.
📎 Vị trí trong đề thi: hai bài trước đã cho bạn công cụ: Bài 53 giữ hệ thống chạy khi một phần hỏng, Bài 54 giữ các bản sao để lấy lại dữ liệu. Bài này đặt mục tiêu bằng con số cho hai việc đó, rồi lập kế hoạch cho tình huống xấu nhất: cả một địa điểm ngừng hoạt động. Các con số RTO, RPO thường xuất phát từ phân tích tác động kinh doanh (BIA), sẽ học ở Bài 95.
💡 Liên hệ thực tế: "bao lâu có lại, mất bao nhiêu?"
Sau sự cố ở Bài 54, chị Lan hỏi Nam hai câu mà giám đốc chắc chắn sẽ hỏi lại: "Nếu máy chủ hỏng, bao lâu thì website bán hàng chạy lại? Và chúng ta mất tối đa bao nhiêu đơn hàng?"
Nam không trả lời bằng cảm tính. Anh hỏi ban lãnh đạo: website tối đa được ngừng bao lâu, và có thể chịu mất bao nhiêu dữ liệu đơn hàng? Câu trả lời: không quá 4 giờ ngừng hoạt động và không quá 1 giờ dữ liệu. Nhưng hiện tại công ty chỉ sao lưu mỗi đêm, nghĩa là có thể mất tới 24 giờ dữ liệu: thực tế chưa đạt mục tiêu. Đây là tình huống minh họa, không phải vụ việc có thật.
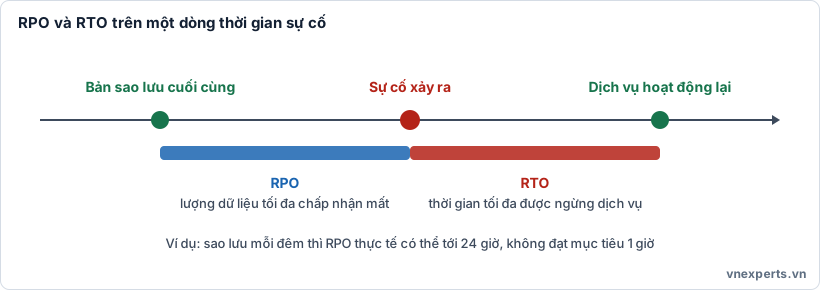
⏱️ Hình 55a. RPO đo dữ liệu có thể mất (nhìn về quá khứ), RTO đo thời gian được phép ngừng (nhìn về tương lai).
📘 Kiến thức cốt lõi
🎯 RPO — Recovery Point Objective
RPO là lượng dữ liệu tối đa mà tổ chức chấp nhận mất, tính bằng thời gian (ví dụ 1 giờ, 15 phút). Nó trả lời: "khôi phục về thời điểm gần nhất nào là chấp nhận được?"
- RPO quyết định tần suất sao lưu hoặc replication. RPO 1 giờ nghĩa là phải có ít nhất một bản sao (hoặc bản sao đồng bộ) mỗi giờ. Sao lưu mỗi đêm chỉ phù hợp khi tổ chức chấp nhận mất tới 24 giờ dữ liệu.
- RPO càng nhỏ thì càng tốn kém: tiến dần tới replication liên tục.
⏱️ RTO — Recovery Time Objective
RTO là thời gian tối đa cho phép để khôi phục dịch vụ sau sự cố, tính từ lúc dịch vụ ngừng. Nó trả lời: "dịch vụ được phép ngừng bao lâu?"
- RTO quyết định mức đầu tư dự phòng: RTO vài phút đòi hỏi HA/failover tự động (Bài 53); RTO vài ngày có thể chấp nhận khôi phục thủ công từ sao lưu.
- Cả RTO và RPO là mục tiêu do doanh nghiệp đặt ra (dựa trên mức độ quan trọng của từng hệ thống), không phải số đo thực tế. Số đo thực tế có được nhờ kiểm thử khôi phục (Bài 54). Nếu thời gian khôi phục thực tế vượt RTO thì phải cải thiện giải pháp.
💡 Ngoài RTO và RPO, tài liệu về liên tục kinh doanh còn dùng MTD (Maximum Tolerable Downtime): mức ngừng hoạt động tối đa mà doanh nghiệp chịu được trước khi gặp hậu quả nghiêm trọng. RTO thường được đặt nhỏ hơn MTD.
📊 MTBF và MTTR — đo độ tin cậy và khả năng sửa chữa
| Chỉ số | Tên đầy đủ | Ý nghĩa | Cách tính |
|---|---|---|---|
| MTBF | Mean Time Between Failures | Thời gian trung bình giữa hai lần hỏng: đo độ tin cậy | Tổng thời gian hoạt động ÷ số lần hỏng |
| MTTR | Mean Time To Repair (cũng gặp: To Recover/Restore) | Thời gian trung bình để sửa hoặc khôi phục sau mỗi lần hỏng: đo khả năng phục hồi | Tổng thời gian sửa chữa ÷ số lần sửa |
Ví dụ: một máy chủ chạy 1.000 giờ, hỏng 4 lần, tổng thời gian sửa là 8 giờ.
- MTBF = 1.000 ÷ 4 = 250 giờ (trung bình cứ 250 giờ hỏng một lần).
- MTTR = 8 ÷ 4 = 2 giờ (mỗi lần hỏng mất trung bình 2 giờ để sửa).
- Độ sẵn sàng xấp xỉ = MTBF ÷ (MTBF + MTTR) = 250 ÷ 252 ≈ 99,2%.
Hiểu theo hướng hành động: muốn tăng tính sẵn sàng thì tăng MTBF (phần cứng tốt hơn, bảo trì phòng ngừa, vá lỗi kịp thời) và giảm MTTR (thiết bị dự phòng sẵn, quy trình khôi phục rõ ràng, tự động hóa). Lưu ý: MTBF và MTTR là giá trị trung bình thống kê, không dự đoán chính xác lần hỏng kế tiếp.
📋 Kế hoạch khôi phục sau thảm họa (DR plan)
Disaster Recovery plan là tài liệu mô tả cách khôi phục hạ tầng và dịch vụ IT sau một sự cố nghiêm trọng (cháy, ngập, mất điện kéo dài, tấn công diện rộng). Một kế hoạch DR thường có:
- Phạm vi và danh sách hệ thống, kèm thứ tự ưu tiên khôi phục (hệ thống nào lên trước).
- RTO và RPO của từng hệ thống.
- Vai trò, trách nhiệm và danh bạ liên lạc, kể cả người thay thế.
- Quy trình khôi phục từng bước, vị trí lưu bản sao lưu và site dự phòng.
- Kế hoạch truyền thông (thông báo nhân viên, khách hàng, cơ quan chức năng khi cần).
- Lịch kiểm thử và quy trình cập nhật kế hoạch.
DR plan khác BCP (Business Continuity Plan): BCP rộng hơn, đảm bảo toàn bộ hoạt động kinh doanh tiếp tục (con người, quy trình, địa điểm làm việc, nhà cung cấp), còn DR plan tập trung vào khôi phục công nghệ thông tin. DR plan là một phần của bức tranh BCP.
🏢 Site khôi phục: hot, warm, cold
Khi địa điểm chính không dùng được, tổ chức chuyển sang site dự phòng. Có ba mức:
| Loại site | Đặc điểm | Thời gian phục hồi (thường) | Chi phí |
|---|---|---|---|
| Hot site | Đủ thiết bị, dữ liệu đồng bộ liên tục, sẵn sàng tiếp nhận tải ngay | Phút đến giờ | Cao nhất |
| Warm site | Có phần cứng và mạng sẵn sàng, nhưng phải khôi phục dữ liệu từ sao lưu | Giờ đến ngày | Trung bình |
| Cold site | Chỉ có không gian, điện, đường truyền; phải mang thiết bị tới lắp đặt | Ngày đến tuần | Thấp nhất |
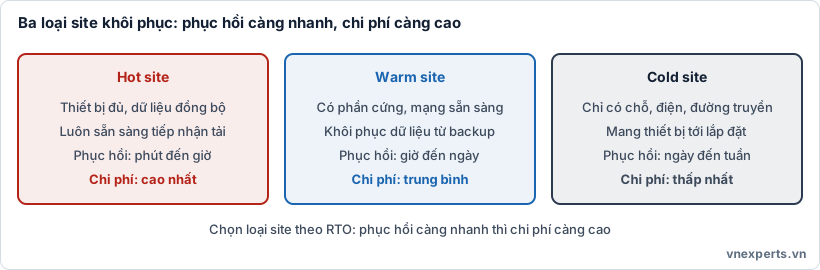
🏢 Hình 55b. Chọn loại site theo RTO của hệ thống: RTO càng ngắn thì càng cần site nóng.
Hai ý bổ sung: phân tán địa lý (geographic dispersion), đặt site dự phòng đủ xa để cùng một thiên tai không ảnh hưởng cả hai nơi; và cloud ngày càng được dùng làm môi trường khôi phục thay cho site vật lý riêng, vì có thể dựng tài nguyên khi cần.
🧪 Kiểm thử kế hoạch DR
Kế hoạch chưa được thử thì chưa đáng tin. Các hình thức kiểm thử, từ nhẹ tới nặng:
- Tabletop exercise: các bên ngồi lại thảo luận theo một kịch bản giả định, không đụng vào hệ thống thật. Rẻ, nhanh, tốt để phát hiện lỗ hổng trong quy trình và phân công.
- Simulation (mô phỏng): diễn tập kịch bản sát thực tế hơn, người tham gia thực hiện các bước như thật nhưng trong môi trường mô phỏng.
- Parallel test (kiểm thử song song): bật hệ thống tại site dự phòng và chạy song song với hệ thống chính để kiểm tra, không chuyển lưu lượng thật sang.
- Failover test (chuyển đổi thật): thực sự chuyển lưu lượng sang site dự phòng, rồi quay lại (failback). Độ tin cậy cao nhất nhưng cũng rủi ro nhất nếu chuẩn bị chưa kỹ.
Sau mỗi lần thử, ghi lại bài học và cập nhật kế hoạch. Đây cũng là cách đo MTTR và thời gian khôi phục thực tế để so với RTO.
🎯 Mẹo làm bài: "Tối đa bao nhiêu dữ liệu chấp nhận mất, tính bằng thời gian" → RPO. "Tối đa bao lâu phải hoạt động lại" → RTO. "Trung bình bao lâu hỏng một lần" → MTBF. "Trung bình mất bao lâu để sửa/khôi phục" → MTTR. "Đủ thiết bị và dữ liệu đồng bộ, chuyển sang gần như ngay" → hot site. "Có phần cứng nhưng phải khôi phục dữ liệu" → warm site. "Chỉ có không gian và điện" → cold site. "Thảo luận kịch bản, không đụng hệ thống thật" → tabletop.
🧠 Áp vào câu chuyện của Nam
| Câu hỏi của chị Lan | Khái niệm trả lời |
|---|---|
| "Website tối đa được ngừng bao lâu?" | RTO: 4 giờ |
| "Mất tối đa bao nhiêu dữ liệu đơn hàng?" | RPO: 1 giờ, nên sao lưu mỗi đêm là chưa đạt |
| "Con server này thường hỏng bao lâu một lần, mỗi lần sửa mất bao lâu?" | MTBF và MTTR |
| "Cả văn phòng ngập nước thì sao?" | DR plan + site khôi phục (hot/warm/cold) phù hợp RTO |
| "Làm sao biết kế hoạch có chạy được?" | Kiểm thử: tabletop, simulation, parallel, failover |
📖 Thuật ngữ cần nhớ
| Thuật ngữ | Nghĩa |
|---|---|
| RPO | Lượng dữ liệu tối đa chấp nhận mất, tính bằng thời gian. |
| RTO | Thời gian tối đa cho phép để khôi phục dịch vụ. |
| MTD | Mức ngừng hoạt động tối đa doanh nghiệp chịu được; RTO thường nhỏ hơn MTD. |
| MTBF | Thời gian trung bình giữa hai lần hỏng. |
| MTTR | Thời gian trung bình để sửa hoặc khôi phục sau mỗi lần hỏng. |
| DR plan | Kế hoạch khôi phục hạ tầng và dịch vụ IT sau thảm họa. |
| BCP | Kế hoạch duy trì toàn bộ hoạt động kinh doanh; rộng hơn DR plan. |
| Hot / warm / cold site | Site dự phòng từ sẵn sàng ngay (đắt) đến chỉ có không gian (rẻ). |
| Tabletop exercise | Diễn tập bằng thảo luận kịch bản, không đụng hệ thống thật. |
| Failback | Chuyển hoạt động từ site dự phòng trở lại site chính sau khi sự cố được xử lý. |
📌 Tóm tắt nhanh
- RPO = dữ liệu tối đa chấp nhận mất (quyết định tần suất sao lưu/replication); RTO = thời gian tối đa được ngừng (quyết định mức dự phòng).
- RTO và RPO là mục tiêu; thời gian khôi phục thực tế được kiểm chứng bằng thử khôi phục.
- MTBF = tổng thời gian hoạt động ÷ số lần hỏng; MTTR = tổng thời gian sửa ÷ số lần sửa; độ sẵn sàng ≈ MTBF ÷ (MTBF + MTTR).
- DR plan tập trung IT, BCP bao trùm toàn bộ kinh doanh; site khôi phục có ba mức hot, warm, cold, đánh đổi giữa tốc độ và chi phí.
- Kiểm thử DR từ nhẹ tới nặng: tabletop, simulation, parallel, failover.
💬 Hỏi & Đáp nhanh
❓ RTO và RPO có phải luôn bằng nhau không? Không. Hai chỉ số độc lập: một hệ thống có thể chịu ngừng 8 giờ nhưng không chịu mất quá 5 phút dữ liệu (RTO dài, RPO ngắn), và ngược lại. Mỗi hệ thống nên có cặp RTO/RPO riêng.
❓ RTO bằng 0 và RPO bằng 0 có khả thi không? Về nguyên tắc cần HA active-active và replication đồng bộ (gần như không có thời gian ngừng và không mất dữ liệu), đòi hỏi chi phí rất lớn. Doanh nghiệp thường chỉ áp dụng cho hệ thống thật sự sống còn.
❓ MTBF cao có nghĩa là thiết bị sẽ không hỏng trong thời gian đó? Không. MTBF là giá trị trung bình thống kê trên nhiều thiết bị hoặc nhiều lần hỏng, không phải lời hứa về một thiết bị cụ thể. Nó dùng để so sánh độ tin cậy và lập kế hoạch dự phòng.
📝 Bài tập đánh giá
Tự chọn đáp án cho từng câu, rồi đối chiếu với phần đáp án ở cuối bài.
Câu 1. Chỉ số nào mô tả lượng dữ liệu tối đa mà tổ chức chấp nhận mất, tính bằng thời gian?
- A. RTO
- B. MTTR
- C. RPO
- D. MTBF
Câu 2. Ban lãnh đạo yêu cầu website phải hoạt động lại trong vòng 2 giờ kể từ khi ngừng. Yêu cầu này là chỉ số nào?
- A. RTO
- B. RPO
- C. MTBF
- D. Phạm vi của BCP
Câu 3. Một hệ thống có RPO là 1 giờ. Phương án sao lưu nào không đáp ứng được?
- A. Sao lưu mỗi 30 phút
- B. Replication gần liên tục sang site khác
- C. Sao lưu mỗi 15 phút kết hợp nhật ký thay đổi
- D. Chỉ sao lưu full mỗi đêm
Câu 4. Một thiết bị chạy 600 giờ và hỏng 3 lần. Tổng thời gian sửa chữa là 6 giờ. MTBF và MTTR lần lượt là bao nhiêu?
- A. MTBF 200 giờ, MTTR 6 giờ
- B. MTBF 200 giờ, MTTR 2 giờ
- C. MTBF 2 giờ, MTTR 200 giờ
- D. MTBF 600 giờ, MTTR 3 giờ
Câu 5. Site dự phòng đã có phần cứng và kết nối mạng, nhưng cần khôi phục dữ liệu từ bản sao lưu trước khi dùng được. Đây là loại site nào?
- A. Hot site
- B. Cold site
- C. Warm site
- D. Mirror site
👉 Đáp án
Câu 1: C — RPO (Recovery Point Objective) là lượng dữ liệu tối đa chấp nhận mất, tính bằng thời gian.
Câu 2: A — Thời gian tối đa được ngừng dịch vụ là RTO.
Câu 3: D — Chỉ sao lưu full mỗi đêm có thể làm mất tới 24 giờ dữ liệu, vượt RPO 1 giờ. Các phương án còn lại đều có điểm khôi phục trong vòng 1 giờ.
Câu 4: B — MTBF = 600 ÷ 3 = 200 giờ; MTTR = 6 ÷ 3 = 2 giờ.
Câu 5: C — Có phần cứng và mạng sẵn sàng nhưng phải khôi phục dữ liệu là đặc điểm của warm site.
📚 Bài viết thuộc khóa học CompTIA Security+ của VNExperts
🧭 Điều hướng
| ⬅️ Bài trước | 🏠 Mục lục khóa học | Bài kế tiếp ➡️ |
|---|---|---|
| Bài 54: Sao lưu và phục hồi | Mục lục khóa học CompTIA Security+ | Bài 56: (Lab) Mạng phân đoạn với pfSense: DMZ, firewall rule, VPN |


