


 Khóa học CompTIA Security+ OnlineBài 35. AI và LLM trong bảo mật (2): data loss, privacy, bias, hallucination, explainability, session hijacking, code execution
Bài 35. AI và LLM trong bảo mật (2): data loss, privacy, bias, hallucination, explainability, session hijacking, code execution
Khóa học CompTIA Security+ SY0-801 · Phần 2: Mối đe dọa, lỗ hổng và tấn công · Bài 35 · 🎯 Objective 2.6 (mới trong V8) · ⏱️ Đọc khoảng 14 phút · 🧪 Không cần lab · 📝 5 câu bài tập cuối bài
🎯 Mục tiêu bài học
- Mô tả rò rỉ dữ liệu và rủi ro quyền riêng tư khi dùng AI.
- Hiểu thiên lệch (bias), ảo giác (hallucination) và khả năng giải thích (explainability).
- Nhận biết chiếm phiên (session hijacking) của phiên làm việc với AI và rủi ro thực thi mã.
- Chọn biện pháp quản trị: chính sách, DLP, quyền tối thiểu, sandbox, con người duyệt.
📎 Vị trí trong đề thi: tiếp nối Bài 34. Phần này thiên về rủi ro khi sử dụng và triển khai AI trong tổ chức. Đề dự kiến hỏi ở mức khái niệm và biện pháp quản trị.
💡 Liên hệ thực tế: nhân viên và công cụ AI
Thứ Năm, 10:30. Sau khi công ty chị Lan cho dùng AI, Nam gặp năm tình huống. Đây là tình huống minh họa, không phải vụ việc có thật.
| Tình huống | Rủi ro |
|---|---|
| Nhân viên dán hợp đồng và danh sách khách hàng vào một công cụ AI miễn phí để tóm tắt | Rò rỉ dữ liệu: dữ liệu ra khỏi công ty, có thể được lưu hoặc dùng để huấn luyện |
| Trợ lý AI trích dẫn một điều khoản luật không có thật một cách rất tự tin | Hallucination: nội dung sai nhưng thuyết phục |
| Bộ lọc AI chấm điểm hồ sơ tuyển dụng thấp hơn cho một nhóm người, không ai giải thích được vì sao | Thiên lệch và thiếu khả năng giải thích |
| Liên kết phiên chat AI của một người bị chia sẻ, người khác mở lên xem được cuộc trò chuyện | Chiếm hoặc lộ phiên |
| Một tác tử AI nối với máy chủ được cho chạy lệnh theo gợi ý từ nội dung một trang web | Thực thi mã từ đầu ra hoặc chỉ dẫn không đáng tin |
Chị Lan hỏi: "Vậy cấm dùng AI?" Nam trả lời: cấm hẳn thường khiến người dùng lén dùng công cụ ngoài kiểm soát. Hướng tốt hơn là chính sách rõ ràng, công cụ được duyệt và các biện pháp kỹ thuật đi kèm.
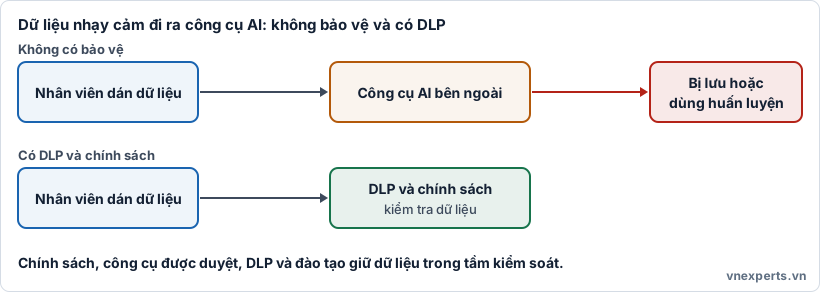
📤 Hình 35a. Khi dán dữ liệu vào công cụ AI không được duyệt, dữ liệu rời khỏi tầm kiểm soát. DLP và chính sách giúp chặn từ sớm.
📘 Kiến thức cốt lõi
📤 Data loss và quyền riêng tư
Khi nhân viên đưa dữ liệu nhạy cảm (mã nguồn, hợp đồng, dữ liệu cá nhân khách hàng) vào công cụ AI bên ngoài, dữ liệu rời khỏi tổ chức. Tùy điều khoản của nhà cung cấp, nó có thể được lưu trữ, dùng để cải thiện mô hình hoặc lộ qua sự cố.
Rủi ro liên quan:
- Vi phạm quy định về dữ liệu cá nhân và nghĩa vụ hợp đồng bảo mật.
- Mô hình ghi nhớ và vô tình lặp lại thông tin đã học (rò rỉ dữ liệu huấn luyện).
- Suy ra thông tin riêng tư từ mô hình (ví dụ cố khôi phục dữ liệu huấn luyện).
- Shadow IT với công cụ AI (Bài 27).
Giảm thiểu:
- Chính sách sử dụng AI chấp nhận được: loại dữ liệu nào không được đưa vào.
- Công cụ AI được duyệt, bản dành cho doanh nghiệp với cam kết không dùng dữ liệu để huấn luyện, thỏa thuận xử lý dữ liệu rõ ràng.
- DLP (chống thất thoát dữ liệu, Bài 4 và các bài sau) chặn hoặc cảnh báo khi dữ liệu nhạy cảm đi tới dịch vụ AI.
- Phân loại dữ liệu, ẩn danh hoặc che thông tin cá nhân trước khi đưa vào.
- Đào tạo nhân viên.
⚖️ Thiên lệch (bias)
Mô hình học từ dữ liệu, mà dữ liệu thường phản ánh thiên lệch của xã hội hoặc không cân đối giữa các nhóm. Kết quả: mô hình đưa ra quyết định bất công hoặc kém chính xác với một số nhóm (tuyển dụng, tín dụng, nhận diện).
Giảm thiểu: dữ liệu đa dạng và cân đối, kiểm tra công bằng theo từng nhóm, theo dõi sau triển khai, người xem xét các quyết định ảnh hưởng đến con người.
🌫️ Hallucination (ảo giác)
LLM có thể sinh ra thông tin sai nhưng nghe rất thuyết phục: số liệu, trích dẫn, tên hàm hay gói phần mềm không tồn tại. Mô hình dự đoán chữ hợp lý chứ không "kiểm chứng sự thật".
Rủi ro bảo mật: làm theo hướng dẫn sai, trích dẫn tài liệu bịa, và cả gợi ý gói phần mềm không có thật, mà kẻ tấn công có thể đăng ký tên đó để cài mã độc (liên quan chuỗi cung ứng, Bài 20).
Giảm thiểu: kiểm chứng thông tin quan trọng với nguồn đáng tin, cho AI trích nguồn có thể kiểm tra (truy xuất từ tài liệu thật), con người duyệt kết quả trong việc quan trọng, và đào tạo người dùng không tin tuyệt đối.
🔍 Explainability (khả năng giải thích)
Nhiều mô hình là "hộp đen": khó nói vì sao nó đưa ra một kết quả. Điều này ảnh hưởng tới kiểm toán, tuân thủ, điều tra sự cố và niềm tin.
Giảm thiểu: chọn hoặc bổ sung kỹ thuật cho phép giải thích quyết định, ghi nhật ký đầu vào và đầu ra, ghi lại phiên bản mô hình và dữ liệu, và giữ con người trong vòng quyết định với những việc có hậu quả.
🔗 Session hijacking với AI
Phiên làm việc với dịch vụ AI cũng dựa vào cookie, token, liên kết chia sẻ. Nếu chúng bị đánh cắp hoặc bị lộ, kẻ tấn công có thể xem lịch sử trò chuyện (chứa dữ liệu nhạy cảm) hoặc hành động thay người dùng, nhất là khi trợ lý có quyền gọi công cụ.
Giảm thiểu: như bảo vệ phiên web thông thường (Bài 25, 31): cookie Secure và HttpOnly, hết hạn phiên, MFA, không chia sẻ liên kết phiên, kiểm soát quyền của liên kết chia sẻ và dữ liệu lưu trữ.
💻 Code execution và hành động ngoài ý muốn
Khi LLM được nối với công cụ (chạy mã, gọi API, thao tác tệp), đầu ra của nó có thể trở thành hành động. Nếu bị prompt injection (Bài 34), hoặc đầu ra được tin tưởng mù quáng, hậu quả là thực thi mã tùy ý, xóa dữ liệu, gửi dữ liệu ra ngoài. Rủi ro này gọi chung là xử lý đầu ra không an toàn và quyền hạn quá mức (excessive agency).
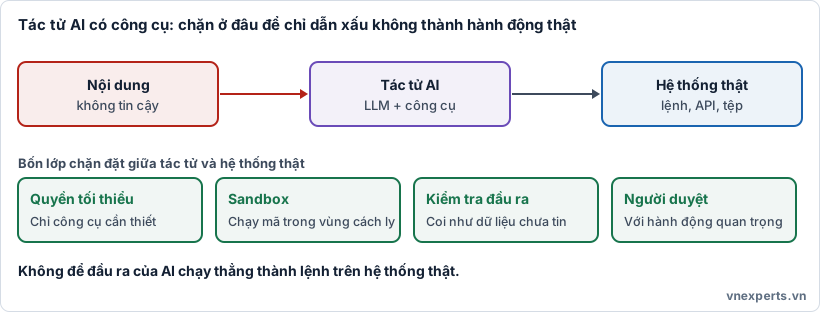
💻 Hình 35b. Mỗi lớp (quyền tối thiểu, sandbox, kiểm tra đầu ra, người duyệt) giảm khả năng một chỉ dẫn xấu thành hành động thật.
Giảm thiểu:
- Quyền tối thiểu cho tác tử: chỉ những công cụ và dữ liệu cần thiết.
- Sandbox (môi trường cách ly) khi chạy mã do AI sinh ra.
- Kiểm tra và làm sạch đầu ra trước khi chuyển cho hệ thống khác, như dữ liệu không đáng tin.
- Con người duyệt hành động có hậu quả.
- Giới hạn tốc độ, hạn mức và ghi nhật ký mọi lệnh gọi công cụ.
🛡️ Bảng tổng hợp
| Rủi ro | Dấu hiệu | Giảm thiểu chính |
|---|---|---|
| Rò rỉ dữ liệu, quyền riêng tư | Dán dữ liệu nhạy cảm vào AI ngoài | Chính sách, công cụ được duyệt, DLP, đào tạo |
| Thiên lệch | Kết quả bất công với một nhóm | Dữ liệu cân đối, kiểm tra công bằng, người xem xét |
| Hallucination | Thông tin sai nhưng thuyết phục | Kiểm chứng, trích nguồn, người duyệt |
| Explainability | Không giải thích được quyết định | Ghi nhật ký, kỹ thuật giải thích, người trong vòng quyết định |
| Session hijacking | Lộ phiên hoặc lịch sử chat | Cookie an toàn, hết hạn phiên, MFA, kiểm soát chia sẻ |
| Code execution | AI chạy lệnh theo chỉ dẫn xấu | Quyền tối thiểu, sandbox, kiểm tra đầu ra, người duyệt |
🎯 Mẹo làm bài: nhìn hậu quả. "Dán dữ liệu mật vào công cụ AI ngoài" là data loss, chọn DLP và chính sách. "Thông tin bịa nhưng tự tin" là hallucination, chọn kiểm chứng. "Quyết định bất công với một nhóm" là bias. "Không biết vì sao mô hình ra kết quả" là explainability. "Phiên hoặc liên kết chat bị lộ" là session hijacking. "AI chạy mã hay lệnh theo chỉ dẫn xấu" là code execution, chọn quyền tối thiểu, sandbox và người duyệt.
🧠 Áp vào câu chuyện của Nam
| Câu hỏi của chị Lan | Khái niệm trả lời |
|---|---|
| "Dán hợp đồng vào AI miễn phí có sao không?" | Data loss: dữ liệu rời khỏi công ty, cần chính sách và DLP |
| "AI trích luật không có thật?" | Hallucination: cần kiểm chứng nguồn |
| "Bộ lọc tuyển dụng chấm thấp một nhóm?" | Bias: cần kiểm tra công bằng và người xem xét |
| "Liên kết chat bị người khác mở được?" | Session hijacking: kiểm soát chia sẻ, hết hạn phiên |
| "Có nên cho AI chạy lệnh trên máy chủ?" | Chỉ với quyền tối thiểu, sandbox và người duyệt |
📖 Thuật ngữ cần nhớ
| Thuật ngữ | Nghĩa |
|---|---|
| Data loss / leakage | Dữ liệu nhạy cảm rời khỏi tầm kiểm soát. |
| DLP | Chống thất thoát dữ liệu: phát hiện và chặn dữ liệu nhạy cảm đi ra. |
| Privacy | Quyền riêng tư: bảo vệ dữ liệu cá nhân. |
| Bias | Thiên lệch hệ thống trong kết quả của mô hình. |
| Hallucination | Mô hình sinh thông tin sai nhưng thuyết phục. |
| Explainability | Khả năng giải thích vì sao mô hình ra kết quả. |
| Session hijacking | Chiếm phiên làm việc đang hợp lệ. |
| Excessive agency | AI có quyền hay công cụ quá mức cần thiết. |
| Sandbox | Môi trường cách ly để chạy mã không tin cậy. |
| Human in the loop | Con người duyệt các quyết định, hành động quan trọng. |
📌 Tóm tắt nhanh
- Dùng AI không kiểm soát có thể làm lộ dữ liệu. Cần chính sách, công cụ được duyệt, DLP, đào tạo.
- Thiên lệch, hallucination, thiếu giải thích là rủi ro về độ tin cậy. Cần kiểm chứng, nhật ký và người xem xét.
- Phiên AI cũng cần bảo vệ như phiên web: cookie an toàn, hết hạn phiên, MFA.
- AI có công cụ có thể thực thi mã: quyền tối thiểu, sandbox, kiểm tra đầu ra, người duyệt.
- Nguyên tắc chung: không tin mù quáng đầu ra của AI, và giữ con người trong vòng quyết định.
💬 Hỏi & Đáp nhanh
❓ Hallucination có phải là lỗ hổng bảo mật không? Bản thân nó là hạn chế về độ tin cậy, nhưng trở thành rủi ro bảo mật khi người dùng làm theo thông tin sai (ví dụ cài gói phần mềm không có thật) hoặc dùng làm cơ sở quyết định quan trọng.
❓ Có thể tin cam kết "không dùng dữ liệu để huấn luyện" của nhà cung cấp không? Nên đọc kỹ điều khoản và thỏa thuận, ưu tiên bản doanh nghiệp có cam kết bằng văn bản, và vẫn áp dụng DLP. Cam kết không thay thế được kiểm soát kỹ thuật của chính mình.
❓ Vì sao cần con người duyệt dù AI "thông minh"? Vì AI có thể sai, bị lừa bằng prompt injection hay thiên lệch. Với hành động có hậu quả (chuyển tiền, xóa, gửi dữ liệu), người duyệt là lớp bảo vệ cuối.
📝 Bài tập đánh giá
Tự chọn đáp án cho từng câu, rồi đối chiếu với phần đáp án ở cuối bài.
Câu 1. Nhân viên dán danh sách khách hàng vào một công cụ AI miễn phí không được duyệt. Rủi ro chính và biện pháp phù hợp là gì?
- A. Rò rỉ dữ liệu. Dùng chính sách sử dụng AI, công cụ được duyệt và DLP
- B. Jamming. Tăng công suất Wi-Fi
- C. VM sprawl. Xóa máy ảo
- D. Skimming. Dùng thẻ chip
Câu 2. Một trợ lý AI trích dẫn một điều luật không tồn tại nhưng rất thuyết phục. Đây là gì?
- A. Hallucination
- B. Jailbreaking
- C. Replay
- D. Rootkit
Câu 3. Hệ thống chấm điểm hồ sơ cho kết quả thấp hơn một cách hệ thống với một nhóm người vì dữ liệu huấn luyện không cân đối. Đây là vấn đề gì?
- A. Bias (thiên lệch)
- B. Worm
- C. Typosquatting
- D. Deauthentication
Câu 4. Một tác tử AI được nối với máy chủ có thể chạy lệnh. Biện pháp nào giảm rủi ro nhất khi nó bị chỉ dẫn xấu?
- A. Cho tác tử quyền quản trị toàn hệ thống để linh hoạt
- B. Quyền tối thiểu, chạy mã trong sandbox, kiểm tra đầu ra và người duyệt hành động quan trọng
- C. Tắt nhật ký để tiết kiệm dung lượng
- D. Tin hoàn toàn đầu ra của AI
Câu 5. Liên kết một cuộc trò chuyện AI chứa dữ liệu nhạy cảm bị chia sẻ rộng rãi, ai có đường dẫn cũng xem được. Biện pháp nào phù hợp?
- A. Kiểm soát quyền của liên kết chia sẻ, hết hạn phiên và bật MFA
- B. Đổi màu giao diện
- C. Thêm quảng cáo
- D. Không làm gì vì đường dẫn dài khó đoán
👉 Đáp án
Câu 1: A — Dữ liệu rời khỏi tổ chức là rò rỉ dữ liệu. Chính sách, công cụ được duyệt và DLP là các biện pháp phù hợp.
Câu 2: A — Thông tin sai nhưng thuyết phục do mô hình sinh ra là hallucination. Cần kiểm chứng nguồn.
Câu 3: A — Kết quả bất công vì dữ liệu không cân đối là thiên lệch (bias).
Câu 4: B — Quyền tối thiểu, sandbox, kiểm tra đầu ra và người duyệt hành động quan trọng giảm khả năng chỉ dẫn xấu thành hành động thật.
Câu 5: A — Kiểm soát quyền của liên kết chia sẻ, hết hạn phiên và MFA. "Đường dẫn khó đoán" không phải biện pháp bảo vệ.
📚 Bài viết thuộc khóa học CompTIA Security+ của VNExperts


